تصور کنید چند ماه برای تدوین پروپوزال، دریافت مجوز، جمعآوری پرسشنامه یا ثبت اطلاعات بیماران وقت گذاشتهاید. اکنون فایل داده را وارد SPSS میکنید و آمادهاید آزمونهای آماری پایاننامه را انجام دهید؛ اما با خانههای خالی، کدهای نامشخص مانند 99 و -1 یا پاسخهای ثبتنشده روبهرو میشوید. در این لحظه معمولاً دانشجو یک سؤال نگرانکننده میپرسد: «با دادههای گمشده چه کار کنم؟ آیا باید آنها را حذف کنم یا عددی بهجای آنها قرار دهم؟»
بهعنوان مدرس و پژوهشگری که بارها تحلیل آماری پایاننامهها و مقالات را بررسی کردهام، تأکید میکنم که پاسخ این سؤال برای همه پژوهشها یکسان نیست. داده گمشده یک «خطای نرمافزاری» نیست که با یک کلیک حذف شود؛ بلکه بخشی از واقعیت دادههای پژوهش شماست. اگر بدون بررسی، افراد یا متغیرها را حذف کنید، ممکن است حجم نمونه کاهش پیدا کند، توان آماری مطالعه کم شود و حتی نتیجه نهایی دچار سوگیری (Bias) شود. از طرف دیگر، اگر خانههای خالی را بیدلیل با میانگین یا اعداد دلخواه پر کنید، پراکندگی واقعی دادهها را تغییر میدهید و نتایج را غیرواقعی جلوه میدهید.
در این آموزش جامع از ژیوارآموزان، یاد میگیرید که ابتدا دادههای گمشده در SPSS را تشخیص دهید، سپس نوع گمشدگی را ارزیابی کنید و در نهایت، متناسب با شرایط پژوهش، روش علمی و قابل دفاعی برای مدیریت آنها انتخاب کنید. اگه مایل هستید آموزش نرم افزار SPSS رو به صورت کامل داشته باشید، کلیک کنید.
دادههای گمشده در SPSS چیستند؟
داده گمشده یا Missing Data به هر مقداری گفته میشود که باید برای یک متغیر ثبت میشده، اما در فایل داده وجود ندارد یا قابل استفاده نیست. برای مثال، در یک پرسشنامه کیفیت زندگی، یک شرکتکننده به سؤال مربوط به وضعیت درآمد پاسخ نداده است. یا در مطالعه آزمایشگاهی، نتیجه یک آزمایش بهعلت نقص نمونه ثبت نشده است. هر دو مورد، داده گمشده محسوب میشوند؛ اما علت و روش برخورد با آنها احتمالاً متفاوت است.
در SPSS، دادههای مفقود معمولاً به دو شکل دیده میشوند:
-
System-Missing:
خانه واقعاً خالی است و SPSS آن را با یک نقطه (
.) در نمای دادهها نشان میدهد. این نوع داده گمشده معمولاً زمانی ایجاد میشود که پاسخدهنده به سؤال پاسخ نداده یا داده در زمان ورود اطلاعات ثبت نشده است. -
User-Missing:
پژوهشگر برای پاسخهای نامعتبر یا بدون پاسخ، یک کد تعریف میکند؛ مانند
99،999،-1یا0. برای مثال، در پرسشنامهای با مقیاس ۱ تا ۵، میتوانید کد99را برای «بدون پاسخ» وارد کنید. اما باید حتماً در بخش Variable View و ستون Missing به SPSS اعلام کنید که عدد ۹۹ داده واقعی نیست.
این نکته بسیار حیاتی است. اگر مقدار ۹۹ را بهعنوان Missing تعریف نکنید، SPSS آن را یک پاسخ واقعی تلقی میکند. در نتیجه میانگین، انحراف معیار، ضریب همبستگی و سایر نتایج آماری شما بهشدت مخدوش میشوند.
چرا مدیریت نادرست Missing Data نتایج پژوهش را خراب میکند؟
برخی دانشجویان تصور میکنند چند خانه خالی در فایل داده اهمیت زیادی ندارد. این تصور همیشه درست نیست. شدت اثر دادههای گمشده به سه عامل بستگی دارد: میزان دادههای مفقود، الگوی گمشدگی و اهمیت متغیر موردنظر در تحلیل.
برای مثال، اگر در پژوهشی با ۳۰۰ نفر شرکتکننده، فقط دو پاسخ از یک متغیر فرعی ثبت نشده باشد، احتمالاً اثر زیادی بر تحلیل ندارد. اما اگر ۳۰ درصد دادههای متغیر اصلی پژوهش، مانند «نمره افسردگی»، مفقود باشد، حذف یا جایگزینی نادرست آن میتواند نتیجه کل مطالعه را تغییر دهد.
مدیریت غیرعلمی دادههای گمشده ممکن است پیامدهای زیر را ایجاد کند:
- کاهش غیرضروری حجم نمونه؛
- کاهش توان آماری و افزایش احتمال پیدا نکردن رابطه یا تفاوت واقعی؛
- تغییر میانگین و واریانس متغیرها؛
- ایجاد سوگیری در نتایج، بهخصوص اگر دادههای مفقود تصادفی نباشند؛
- تفاوت تعداد نمونه در آزمونهای گوناگون و دشوار شدن گزارش نتایج؛
- ایراد داوران پایاننامه یا مجلات علمی به روش تحلیل دادهها.
بنابراین، اولین اصل این است: قبل از حذف یا جایگزینی داده، علت و الگوی گمشدگی را بررسی کنید.

انواع دادههای گمشده: MCAR، MAR و MNAR
در آمار، دادههای گمشده معمولاً در سه گروه اصلی طبقهبندی میشوند. درک این سه مفهوم به شما کمک میکند روش مناسب مدیریت Missing Data در SPSS را انتخاب کنید.
۱. دادههای گمشده کاملاً تصادفی (MCAR)
MCAR مخفف Missing Completely at Random است. در این حالت، گمشدن داده هیچ ارتباطی با مقدار آن متغیر یا سایر ویژگیهای افراد ندارد.
برای مثال، تصور کنید بخشی از پاسخهای یک پرسشنامه به دلیل چاپ ناقص برگهها ثبت نشده است. یا فایل مربوط به چند نمونه بهطور اتفاقی در زمان انتقال اطلاعات آسیب دیده است. در این وضعیت، احتمال گمشدن اطلاعات برای همه افراد تقریباً یکسان است.
اگر دادهها واقعاً MCAR باشند و میزان آنها بسیار کم باشد، روشهایی مانند حذف موردی یا جایگزینی ساده میتوانند در شرایط مشخص قابل قبول باشند. البته «کاملاً تصادفی بودن» را نباید فقط بر اساس حدس شخصی اعلام کرد؛ باید تا حد امکان با بررسی الگوها و آزمونهای مناسب ارزیابی شود.
۲. دادههای گمشده تصادفی مشروط (MAR)
MAR مخفف Missing at Random است. نام این مفهوم ممکن است کمی گمراهکننده باشد؛ زیرا دادهها کاملاً تصادفی نیستند. در این حالت، احتمال گمشدن یک متغیر به متغیرهای مشاهدهشده دیگر وابسته است.
برای نمونه، در یک مطالعه سلامت، ممکن است افراد با سن بالاتر کمتر به سؤالهای مربوط به استفاده از اینترنت پاسخ دهند. در اینجا گمشدن پاسخ «استفاده از اینترنت» به سن وابسته است؛ اما اگر سن را در دادهها داشته باشیم، میتوانیم این الگو را مدلسازی کنیم.
بسیاری از روشهای پیشرفته، بهویژه Multiple Imputation یا جایگزینی چندگانه، تحت فرض MAR عملکرد مناسبی دارند. به همین دلیل، در پژوهشهای دانشگاهی و تحلیلهای جدیتر، این روش اغلب بر روش جایگزینی با میانگین ارجحیت دارد.
۳. دادههای گمشده غیرتصادفی (MNAR)
MNAR مخفف Missing Not at Random است. در این حالت، احتمال گمشدن داده به خود مقدار گمشده وابسته است و معمولاً پیچیدهترین وضعیت را ایجاد میکند.
مثلاً در پرسشنامه درآمد، افرادی که درآمد بسیار بالا یا بسیار پایین دارند ممکن است از پاسخ دادن خودداری کنند. یا در یک مطالعه روانشناختی، افرادی با شدت بالای اضطراب ممکن است برخی سؤالهای حساس را خالی بگذارند. در چنین وضعیتی، حذف ساده دادهها یا پرکردن آنها با میانگین میتواند سوگیری جدی ایجاد کند.
برای مدیریت MNAR معمولاً فقط کار با منوهای SPSS کافی نیست. پژوهشگر باید با استاد راهنما، مشاور آماری یا متخصص روش تحقیق درباره علت گمشدگی، تحلیل حساسیت و محدودیتهای مطالعه مشورت کند. مهمتر از همه، این محدودیت باید در بخش بحث مقاله یا پایاننامه شفاف گزارش شود.
گام اول: شناسایی دادههای گمشده در SPSS
پیش از انجام هر آزمون آماری، باید میزان و محل دادههای مفقود را بررسی کنید. برای این کار، ابتدا در Variable View مطمئن شوید کدهای گمشده بهدرستی تعریف شدهاند.
تعریف User-Missing در SPSS
- وارد بخش Variable View شوید.
- در ردیف متغیر موردنظر، ستون Missing را پیدا کنید.
- روی خانه مربوطه کلیک کنید.
- اگر از کدهایی مانند ۹۹ یا ۹۹۹ استفاده کردهاید، گزینه Discrete Missing Values را انتخاب کنید.
- کد موردنظر را وارد و روی OK کلیک کنید.
اکنون SPSS میفهمد که این عدد، پاسخ واقعی نیست و نباید در محاسبات آماری وارد شود.
بررسی فراوانی دادههای گمشده
برای متغیرهای طبقهای یا پرسشنامهای، مسیر زیر ساده و کاربردی است:
Analyze > Descriptive Statistics > Frequencies
متغیرها را انتخاب کنید و خروجی را بررسی کنید. در جدول فراوانی، تعداد Valid و Missing برای هر متغیر نمایش داده میشود.
برای متغیرهای کمی نیز میتوانید از مسیر زیر استفاده کنید:
Analyze > Descriptive Statistics > Descriptives
یا برای بررسی دقیقتر الگوهای گمشدگی، در نسخهها و ماژولهای دارای قابلیت مربوطه، از مسیر زیر استفاده کنید:
Analyze > Missing Value Analysis
در بخش Missing Value Analysis، میتوانید تعداد دادههای گمشده، درصد آنها و الگوهای مفقودشدن را مشاهده کنید. همچنین آزمون Little’s MCAR Test ممکن است در خروجی ارائه شود. اگر نتیجه آزمون لیتل معنادار نباشد، شواهدی علیه فرض MCAR مشاهده نمیشود؛ اما دقت کنید که این نتیجه بهتنهایی اثبات نمیکند دادهها حتماً کاملاً تصادفی هستند.
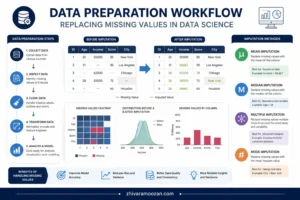
چه زمانی حذف دادههای گمشده قابل قبول است؟
حذف دادهها همیشه اشتباه نیست؛ اما باید آگاهانه و مستند انجام شود. دو روش حذف رایج در SPSS وجود دارد.
حذف کامل مورد یا Listwise Deletion
در روش Listwise Deletion، اگر یک فرد در هر یک از متغیرهای واردشده در تحلیل داده گمشده داشته باشد، کل آن فرد از تحلیل حذف میشود.
فرض کنید ۲۰۰ پرسشنامه دارید و برای تحلیل رگرسیون، پنج متغیر وارد کردهاید. اگر یک شرکتکننده فقط در یکی از این پنج متغیر پاسخ نداده باشد، SPSS او را از تحلیل رگرسیون کنار میگذارد.
این روش زمانی قابل دفاعتر است که:
- درصد دادههای مفقود بسیار کم باشد؛
- دادهها تقریباً MCAR باشند؛
- پس از حذف، حجم نمونه همچنان برای آزمون موردنظر کافی باشد؛
- تعداد افراد حذفشده بهطور شفاف گزارش شود.
اما در دادههای واقعی، حذف کامل مورد میتواند حجم نمونه را بهشدت کاهش دهد. بهویژه در مطالعات با نمونه کم، مانند پژوهشهای بالینی یا پایاننامههایی با دسترسی محدود به آزمودنی، استفاده بیرویه از این روش خطرناک است.
حذف جفتی یا Pairwise Deletion
در Pairwise Deletion، SPSS برای هر محاسبه فقط افرادی را حذف میکند که در متغیرهای همان محاسبه داده گمشده دارند. بنابراین ممکن است تعداد نمونه در ضرایب همبستگی مختلف متفاوت باشد.
این روش گاهی باعث حفظ اطلاعات بیشتری میشود، اما تفسیر نتایج را دشوار میکند؛ چون هر آزمون ممکن است با تعداد متفاوتی از شرکتکنندگان اجرا شده باشد. به همین علت، در گزارشهای رسمی و مدلهای چندمتغیره، معمولاً باید با احتیاط استفاده شود.

جایگزینی با میانگین در SPSS؛ ساده اما محدود
یکی از شناختهشدهترین روشهای جایگزینی دادههای گمشده، پر کردن خانههای خالی با میانگین همان متغیر است. در SPSS این کار از مسیر زیر قابل انجام است:
Transform > Replace Missing Values
پس از انتقال متغیر موردنظر به کادر سمت راست، میتوانید گزینه Series Mean را انتخاب کنید. SPSS یک متغیر جدید ایجاد میکند که مقادیر گمشده آن با میانگین متغیر جایگزین شدهاند.
این روش در نگاه اول جذاب است؛ چون ساده، سریع و قابل اجرا برای همه دانشجویان است. با این حال، بهعنوان یک استاد، توصیه میکنم آن را فقط در شرایط بسیار محدود بهکار ببرید؛ مثلاً زمانی که درصد دادههای مفقود بسیار پایین است و هدف شما تحلیل مقدماتی یا آموزشی است.
مشکل اصلی جایگزینی با میانگین این است که تنوع طبیعی دادهها را کاهش میدهد. وقتی برای چند نفر دقیقاً یک مقدار میانگین قرار میدهید، انحراف معیار کمتر از واقعیت برآورد میشود و روابط بین متغیرها ممکن است ضعیفتر یا متفاوت دیده شوند. بنابراین، برای پژوهشهای جدی، مقاله علمی یا پایاننامه تحصیلات تکمیلی، جایگزینی میانگین معمولاً انتخاب اول نیست.
Multiple Imputation در SPSS؛ روش پیشنهادی برای تحلیل علمیتر
Multiple Imputation یا جایگزینی چندگانه یکی از روشهای استانداردتر برای مدیریت دادههای گمشده است. در این روش، SPSS بهجای آنکه فقط یک عدد قطعی برای هر مقدار گمشده قرار دهد، با استفاده از اطلاعات سایر متغیرها چند مقدار محتمل تولید میکند. سپس چند مجموعه داده کاملشده ایجاد میشود، تحلیل روی همه آنها انجام میگیرد و در پایان نتایج ترکیب میشوند.
مزیت مهم این روش آن است که عدمقطعیت ناشی از گمشدن داده را بهتر از روش میانگین در نظر میگیرد. در واقع، Multiple Imputation وانمود نمیکند که مقدار گمشده را با اطمینان کامل میدانیم؛ بلکه بر اساس الگوهای موجود، چند برآورد منطقی ایجاد میکند.
مسیر معمول در SPSS به شکل زیر است:
Analyze > Multiple Imputation > Impute Missing Data Values
در پنجره بازشده:
- متغیرهایی را که دارای داده گمشده هستند وارد کنید.
- متغیرهای مرتبط و پیشبینیکننده، مانند سن، جنسیت، نمرات مرتبط یا گروه مطالعه را نیز وارد مدل کنید.
- تعداد مجموعههای جایگزینی را تعیین کنید. در بسیاری از شرایط، ۵ مجموعه حداقل رایج است؛ اما با افزایش درصد دادههای مفقود، ممکن است به تعداد بیشتری نیاز باشد.
- محدوده منطقی متغیرها را کنترل کنید؛ برای مثال سن نباید منفی باشد و نمره پرسشنامه نباید خارج از دامنه مجاز قرار گیرد.
- خروجی را ذخیره و سپس تحلیل موردنظر را با مراحل مربوط به Multiple Imputation اجرا کنید.
نکته مهم این است که Multiple Imputation صرفاً «پر کردن خانههای خالی» نیست. برای اینکه نتیجه قابل دفاع باشد، باید متغیرهای مؤثر بر گمشدگی و متغیرهای مرتبط با پیامد اصلی را تا حد امکان در مدل جایگزینی وارد کنید.
یک مثال کاربردی از مدیریت Missing Data در پایاننامه
فرض کنید در یک پایاننامه علوم پزشکی، رابطه کیفیت خواب و قند خون ناشتا در ۱۸۰ بیمار بررسی میشود. از میان شرکتکنندگان، ۱۴ نفر سؤالهای مربوط به کیفیت خواب را ناقص پاسخ دادهاند و ۸ نفر نیز مقدار BMI ندارند.
اولین واکنش نادرست این است که ۲۲ نفر را بهطور کامل حذف کنیم. این کار ممکن است حجم نمونه را از ۱۸۰ به ۱۵۸ نفر کاهش دهد. اگر افراد حذفشده ویژگی خاصی داشته باشند ــ برای مثال سن بالاتر یا بیماری شدیدتر ــ نتایج دیگر نماینده کل نمونه نخواهد بود.
روش اصولیتر این است:
- ابتدا درصد دادههای گمشده هر متغیر بررسی شود؛
- مشخص شود آیا گمشدگی کیفیت خواب با سن، جنسیت یا شدت بیماری ارتباط دارد یا نه؛
- در صورت مناسببودن فرض MAR، متغیرهای سن، جنسیت، BMI، قند خون و کیفیت خواب در مدل Multiple Imputation وارد شوند؛
- تحلیل اصلی روی دادههای جایگزینیشده انجام شود؛
- در گزارش نهایی، درصد دادههای گمشده، روش جایگزینی و تعداد مجموعههای ایجادشده شفاف نوشته شود.
در این مثال، هدف Multiple Imputation این نیست که نتیجه را معنادار کند یا تعداد نمونه را «ظاهراً» بالا ببرد. هدف، استفاده مسئولانه از اطلاعات موجود و کاهش سوگیری ناشی از حذف غیرضروری شرکتکنندگان است.

چگونه دادههای گمشده را در پایاننامه یا مقاله گزارش کنیم؟
یکی از اشتباهات رایج این است که پژوهشگر دادههای گمشده را مدیریت میکند، اما در فصل سوم یا بخش روش مقاله هیچ توضیحی نمیدهد. این کار از نظر علمی قابل قبول نیست. خواننده باید بداند چه میزان داده مفقود بوده و چه روشی برای برخورد با آن استفاده شده است.
نمونه متن قابل استفاده در پایاننامه:
«ابتدا دادهها از نظر مقادیر گمشده بررسی شدند. میزان دادههای مفقود در متغیرهای مورد بررسی کمتر از ۵ درصد بود. پس از ارزیابی الگوی گمشدگی، برای جلوگیری از کاهش حجم نمونه، مقادیر مفقود با روش جایگزینی چندگانه (Multiple Imputation) برآورد شدند. تحلیلهای آماری نهایی بر اساس دادههای تکمیلشده انجام شد.»
اگر از حذف کامل مورد استفاده کردهاید، میتوانید بنویسید:
«مواردی که در متغیرهای اصلی پژوهش داده گمشده داشتند، پس از بررسی میزان و الگوی دادههای مفقود، به روش حذف کامل مورد (Listwise Deletion) از تحلیل نهایی کنار گذاشته شدند.»
البته فقط زمانی این جمله را بنویسید که واقعاً روش شما قابل دفاع باشد.
اشتباهات رایج دانشجویان در برخورد با دادههای گمشده
در پایان، چند اشتباه را که بارها در فایلهای SPSS دانشجویان دیدهام، جدی بگیرید:
- پر کردن خانههای خالی با اعداد تصادفی یا حدسی؛
- جایگزین کردن همه دادههای گمشده با صفر؛
- وارد کردن کدهایی مثل ۹۹ بدون تعریف آنها در بخش Missing؛
- حذف سریع تمام سطرهای دارای یک پاسخ خالی؛
- استفاده از میانگینگذاری بدون توجه به درصد و الگوی گمشدگی؛
- انجام Multiple Imputation بدون واردکردن متغیرهای مرتبط؛
- گزارش نکردن روش مدیریت دادههای گمشده در پایاننامه یا مقاله؛
- تلاش برای استفاده از جایگزینی داده با هدف معنادار کردن نتایج.
یادتان باشد: مدیریت دادههای گمشده باید کیفیت تحلیل را افزایش دهد، نه اینکه نتایج دلخواه پژوهشگر را تولید کند.
جمعبندی و اقدام عملی
دادههای گمشده در SPSS یک مانع غیرقابلحل نیستند، اما برخورد عجولانه با آنها میتواند اعتبار پژوهش شما را کاهش دهد. ابتدا کدهای گمشده را درست تعریف کنید، مقدار و الگوی Missing Data را بررسی کنید، سپس بر اساس نوع داده و هدف تحلیل تصمیم بگیرید که حذف محدود، روشهای جایگزینی ساده یا Multiple Imputation مناسبتر است.
اگر درصد دادههای مفقود بالا است، متغیر اصلی پژوهش شما را درگیر کرده یا قصد دارید مقالهای برای مجله علمی ارسال کنید، پیش از انتخاب روش نهایی حتماً با یک مشاور آماری مشورت کنید.
اقدام پیشنهادی همین امروز: فایل SPSS خود را باز کنید، از مسیر Analyze > Descriptive Statistics > Frequencies تعداد دادههای Valid و Missing هر متغیر را استخراج کنید و در یک جدول ساده بنویسید: نام متغیر، تعداد داده گمشده و درصد آن. همین جدول، نقطه شروع یک تحلیل آماری دقیق و قابل دفاع است.